System Note
$ cat /proc/ai-disclosure
本記事の構成および論理分析にはAI(人工知能)を使用しています。情報の正確性は、システム管理者(UNIXユーザー)による手動検証済みです。

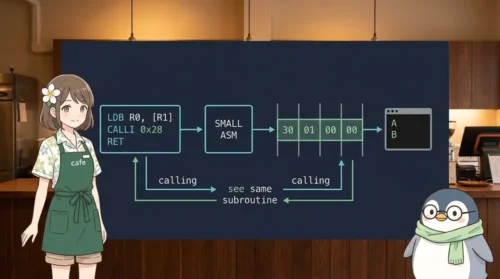
この連載では、C言語で小さなVM(仮想マシン)を組み立てています。ここでのVMは、自分で決めた命令を読み、メモリへ数値を保存したり、画面へ文字を表示したりするプログラムです。今回は、VMで動かす命令と、画面に表示したい文字列を、同じソースファイルへ書けるようにします。
前回は、自作アセンブラの small-asm にラベルを追加しました。ラベルは、メモリの位置に付ける名前です。たとえば CALLI print_byte と書くと、small-asmが print_byte: の位置を調べ、呼び出し先の数値へ置き換えます。アセンブラは、このような文字で書いた命令をVMが読める数値へ変換する道具です。
ただし、前回まで名前を付けていたのは、4バイトずつ並ぶ命令の位置でした。表示する文章は長さが一定ではありません。Hello と Hi では使う場所の数が変わります。今回は、その長さもsmall-asmに数えてもらい、文字列の位置を名前で参照します。
Day 39: tools/small-asm.c
        programs/asm-string.asm
        tools/test-small-asm-strings.py
編集するのは、手元のパソコンで動く変換ツールです。入力の .asm をsmall-asmで .bin へ変換し、できあがったファイルをVMで実行します。文字列表示の SYSCALL 1 は既にあるため、今回はVM本体へ新しい命令を追加しません。
まず追加後のサンプルを動かします。Cコンパイラとmakeを用意し、プロジェクトの Makefile があるディレクトリで実行してください。makeは、必要なコンパイルとバイナリ生成を順番に実行する道具です。
make run-asm-stringビルド時に表示されるコマンドを除くと、結果は次の2行です。今回は入力待ちがないので、キーボードから文字を入力する必要はありません。
Hello, VM!
CPU halted.
1行目がソースに書いた文章で、2行目はVMが停止したときの表示です。変換元の programs/asm-string.asm は、次の短いプログラムです。
; Day 39: jump over data, then print a zero-terminated string.
JUMP start
message: .string "Hello, VM!\n"
.align 4
start:
MOVI R0, message
SYSCALL 1
HALT
最初の JUMP start は、実行する場所を start: へ移します。その間にある message: が文字列の位置です。実行がstartへ着いたら、MOVI R0, message で文字列の先頭アドレスをR0へ入れ、SYSCALL 1 で表示します。最後の HALT は停止する命令です。
R0は数値を一時的に保持するレジスタ、アドレスはメモリの場所を表す番号です。ここではR0へ文章そのものを詰め込むのではなく、「文章はこの番号の場所から始まる」と伝えています。SYSCALL 1はその場所からメモリを1バイトずつ読みます。
今回追加する .string は、二重引用符の内側を文字列データとして並べる指示です。たとえば .string "Hi" は、Hとiの文字コードを並べ、その後ろへ0を1バイト加えます。文字コードは、文字と数値の対応です。今回使うASCIIでは、Hは16進数の0x48、iは0x69です。
.string "Hi"

出力するbyte列:
48 69 00
最後の 00 が終端0です。SYSCALL 1は、メモリの値が0になったところで表示を終えます。先頭位置だけを渡せば終わりまで分かるため、今ある文字列表示の処理をそのまま使えます。文字の 0 は0x30であり、終端を示す0x00とは別の値です。
終端0を毎回手で書く方法もありますが、書き忘れると後ろに置いたデータまで文字として読んでしまいます。そこで今回の .string は、最後に必ず1バイトの0を加える仕様にします。空文字の .string "" でも、この1バイトは必要です。
改行はソースに \n と書きます。このように、バックスラッシュから始まる特別な表記をエスケープと呼びます。ソースでは2文字ですが、出力ではLFという改行コードの1バイト、0x0Aになります。SYSCALL 1が改行を自動で付けるわけではありません。
ソース: "Hello, VM!\n"
本文:   H e l l o , space V M ! LF
長さ:   10 byte + LF 1 byte + 終端0 1 byte = 12 byte
使えるエスケープは \n、\r、\t、\\、\" の5種類です。順に改行、復帰、タブ、バックスラッシュ、二重引用符を表します。途中で表示が切れないよう、文字列内へ0を埋め込む \0 は許しません。
今回の文字列は、生の文字をASCIIの表示可能文字に限定します。英数字、空白、記号は書けますが、日本語はエラーにします。文字列内のタブや改行も、そのまま入力する代わりにエスケープで書きます。
日本語を扱うためには、文字とバイト数の違いも決める必要があります。今は「文字列を置くと、後ろの命令の位置がどう変わるか」を確かめたいので、まず1文字と1バイトの対応が追える範囲に絞ります。ASCIIに絞るのは今回のアセンブラの入力規則であり、VMの文字列表示へ文字コード変換を追加するわけではありません。
文字列: 二重引用符で囲む。末尾へ0を1 byte追加
文字:   ASCIIの表示可能文字と5種類のエスケープ
配置:   .align 4で次の4の倍数まで0を補う
参照:   MOVIの第2引数にもラベルを許す
上限:   出力全体は1 MiB、ラベルの値は0〜0xFFFFF
失敗:   入力の行番号を表示し、指定出力を上書きしない
1行の長さは従来と同じ制限を使います。C側の行バッファは256バイトなので、LF付きの行はLFを含めて255バイトまでです。引用符やラベルもこの長さに含みます。複数行へまたがる文字列や、文字列同士の連結は今回扱いません。
このVMの命令は、どれも4バイトです。文字列を途中へ置くと、その次の位置が4の倍数になるとは限りません。そこで .align 4 を用意します。alignは位置を揃えるという意味で、現在位置から次の4の倍数まで、必要な分だけ0を補います。
このような、アセンブラへ配置などを指示する書き方を指示文と呼びます。.string や .align はVMの命令ではありません。変換後のファイルに残るのは文字や詰め物のバイトであり、VMが「alignという命令」を実行することはありません。
0x00〜0x03  JUMP start              4 byte
0x04〜0x0F  Hello, VM! + LF + 0    12 byte
0x10        .align 4               0 byte(既に揃っている)
0x10〜0x13  MOVI R0, message       4 byte
0x14〜0x17  SYSCALL 1              4 byte
0x18〜0x1B  HALT                   4 byte
最初のサンプルでは、4バイトのJUMPと12バイトの文字列で、合計16バイトです。16は4の倍数なので、.align 4は何も足しません。messageは0x04、startは0x10になります。では、文章を短くするとどうなるでしょうか。
message: .string "Hi!\n"
.align 4
start:
この場合はH、i、!、LF、終端0で5バイトです。JUMPの後の0x04から0x08までを使い、次の空き位置は0x09になります。.align 4が0x09、0x0A、0x0Bへ0を補うので、startは0x0Cです。文章が短くなった分だけ、移動先も変わります。
Hi! + LF + 終端0: 48 69 21 0a 00
整列用の詰め物:   00 00 00

JUMP start:       68 00 00 0c
終端0と詰め物は値こそ同じですが、役割が違います。最初の0は文字列表示を止めるためのもの、その後ろの0は命令の置き場所を揃えるためのものです。文字列長を数えるときは終端0まで、次の命令の位置を数えるときは詰め物も含めます。
命令の前を自動で揃える方法もありますが、今回はソースへ .align 4と明記します。どこに余分なバイトが入るかを、読む人にも見える形にするためです。揃っていない位置に命令を書いたら、small-asmはエラーにします。また、整列後の位置へ名前を付けたい場合は、ラベルを .align 4より後ろへ書きます。
もう1つ区別したいのが、ファイルの配置と実行の順番です。.align 4は詰め物を置くだけなので、実行する場所を移動させません。VMは通常、PCが指す位置から次の4バイトを命令として読みます。PCは、次に実行する命令のアドレスを持つ値です。
文字列が並んでいる場所へ実行が進むと、VMはその文字コードまで命令として読もうとします。今回の先頭にJUMPを置いたのは、その部分を飛び越すためです。文字列をHALTの後ろへ置く方法もありますが、今回は文字列の後ろに命令が来る例にして、整列の役割も見えるようにしました。
PC = 0x00
  JUMP startを読む → PC = 0x10
PC = 0x10
  MOVI R0, messageを読む → R0 = 0x04
PC = 0x14
  SYSCALL 1を読む → memory[0x04]から0まで表示
PC = 0x18
  HALTを読む → 停止
small-asmのラベルには、命令用か文字列用かという分類を付けていません。そのため、文字列のラベルへJUMPしてしまう誤りまでは検査しません。名前が解決できることと、その位置から実行してよいことは別です。実行がデータへ流れ込まないよう、JUMPとHALTの置き場所を確認します。
前回のsmall-asmは、ラベルの位置を「それまでの命令数×4」で求めていました。文字列を置くと、この計算では足りません。命令と文字列と詰め物を合わせて、出力するバイト数を数える変数が必要になります。今回は address を現在位置として使います。
命令を1つ読む       → address += 4
文字列を読む        → address += 本文のbyte数 + 1
.align 4を読む      → address += 必要な詰め物の数
ラベルだけの行を読む → addressは変わらない詰め物の数は、次の式で計算しています。% は割り算の余りを求める演算です。
*length = (4 - address % 4) % 4;addressが9なら、4で割った余りは1です。4から1を引いた3が、補うバイト数になります。addressが16なら余りは0ですが、4バイトを余分に加える必要はありません。最後にもう一度4で割った余りを取ることで、この場合は0になります。
入力を2回読む仕組みは前回と同じです。1回目はラベルの名前と位置を集め、2回目はその表から参照を解決して出力します。今回も、まだ後ろにあるstartを先頭のJUMPから参照できます。2回とも同じ文字列解析と整列計算を使い、同じ位置へ到達することが大切です。
たとえば1回目だけ \n を2バイトと数え、2回目は1バイトへ変換すると、表に記録した位置と実際の出力位置がずれます。今回の assemble_directive は、両方の読み取りで同じbyte列と長さを計算します。1回目は長さを使い、2回目は一時ファイルへそのbyte列を書きます。
もう1つ変更が必要なのが、コメントと大小文字の処理です。従来は行全体を大文字へ揃え、; や # から後ろをコメントとして除去できました。しかし文字列に同じ処理をすると、表示したい文章が変わってしまいます。
message: .string "Hi; #1: Ready, go!" ; ここだけコメントこの例のセミコロン、#、コロン、カンマは、引用符の内側では文章の一部です。小文字のiやgoも、そのまま保存する必要があります。今回の normalize_line は、いま引用符の中にいるかを覚えながら、1文字ずつ読みます。
引用符の外なら、命令名やラベル名を大文字へ揃え、コメントを除去します。中なら文字を保持し、バックスラッシュがあれば、その次の1文字まで読み飛ばして引用符の開閉判定から外します。これで、文字として書いた \" を文字列の終わりと間違えずに済みます。
この処理は文字列を正しい入力として受理するための検査とは別です。使えないエスケープや閉じ忘れた引用符は、後の assemble_directive が検査します。先に文字列を壊さず切り分け、その後で中身の規則を確認する順番です。
ラベル参照をMOVIでも使えるようにするため、数値だけを読んでいた箇所を、前回の parse_target に切り替えました。この関数は、数値ならその値を使い、名前ならラベル表を調べます。名前がまだ出そろっていない1回目は仮の0を使いますが、その段階では出力しません。
MOVI R0, message
message = 0x04

命令値 = 0x40000000 | (0 << 20) | 0x04
       = 0x40000004
byte列 = 40 00 00 04
VMが読むときには、messageという名前は残っていません。4バイトを読み込むfetch、命令の部品へ分けるdecode、処理を行うexecuteの流れは従来通りです。decodeするとtypeは4、opは0、rdは0、immは4になります。rdはレジスタ番号、immは命令の中に直接入っている数値です。
vm->regs[inst.rd] = inst.imm;

/* rd = 0, imm = 4なら */
vm->regs[0] = 4;
続くSYSCALL 1がR0をアドレスとして使い、memory[4]から文字を読みます。MOVIだけでは文字列を読みません。R0の中身が「Hのコード」ではなく「Hが置かれた場所の番号」になっている点を分けると、処理を追いやすくなります。なお、SYSCALLの番号は引き続き数値だけで指定します。
生成されたファイルは、xxdでバイト単位に表示できます。最初のサンプルについて確認します。
xxd programs/asm-string.bin00000000: 6800 0010 4865 6c6c 6f2c 2056 4d21 0a00 h...Hello, VM!..
00000010: 4000 0004 6000 0001 0100 0000 @...`.......先頭の 68 00 00 10 がJUMP、その後ろが文字列です。0x10からは 40 00 00 04、つまり文字列位置4をR0へ入れるMOVIが始まっています。全体は4命令で16バイト、文字列が12バイトの、合計28バイトです。
自動確認では、最初の文章だけでなく、Hi、Hi!、A、空の本文へ置き換えた場合も実行します。必要な詰め物が0〜3バイトの各場合を確かめ、JUMP先と実際の表示を照合します。エラー時には、新しい出力を作らないことと、既にある出力を保持することの両方を検査します。
make test-small-asm test-small-asm-labels test-small-asm-stringssmall-asm: 57 cases passed
small-asm-labels: 44 cases passed
small-asm-strings: 52 cases passedテストにはPython 3を使います。上の表示は実行コマンドの行を省いた結果です。Day 38にあった「MOVIのラベルを拒否する」ケースは、今回の仕様に合わせて「受理する」ケースへ変更しました。文字列用の52ケースでは、引用符内の記号、前後のラベル参照、長さ制限、1 MiBの境界、不正な整列なども確認しています。
文字列の構文やラベルに誤りがあるときは、一時ファイルの段階で処理を止めます。全行の変換が成功してから指定先へコピーするため、入力ミスで既存のバイナリを失うことはありません。ただし、最後のコピーで書き込みのI/Oエラーが起きた場合には、部分的な出力が残り得ます。
今回、短いプログラムなら、命令と表示する文章を同じ.asmへ書けるようになりました。ラベルの位置も、命令数ではなく実際のバイト数から求めます。これで文字列を短くしたときも、後ろの命令への移動先をsmall-asmが数え直せます。
次は、以前のechoコマンドを.asmへ移せるかを確認します。echoには複数の文字列に加え、入力した行を保存する0x500のバッファがあります。バッファは入力のために確保するメモリ領域です。命令と固定文字列を並べた結果、その領域と重ならないかを先に調べます。
そのうえで、現在の順番どおりに並べる書き方で足りるか、指定した番地へ置く絶対配置の指示が必要かを、次の仕様カードで決めます。今回の成功条件は、文字列1つを同じソースから表示するところまでです。そこから1段ずつ、既存のコマンドプログラムを読みやすいソースへ移していきます。

 GMO「お名前.com デスクトップクラウド」不正アクセス|利用者が今できる対策をやさしく解説 | UNIX Cafe
 PHPのニュースをきっかけに、WordPressからEmDashへの移行を試してみた | UNIX Cafe