System Note
$ cat /proc/ai-disclosure
本記事の構成および論理分析にはAI(人工知能)を使用しています。情報の正確性は、システム管理者(UNIXユーザー)による手動検証済みです。
自作VM開発記 21
この連載では、C言語で小さなVM(仮想マシン)を組み立てています。独自に決めた命令をVMが読み取り、文字を表示したり、入力をメモリへ保存したりします。そのVM上で動くプログラムに、入力した文章を表示するechoコマンドを用意してきました。
前回は、echoのプログラムをアセンブリという命令名を使う書き方へ移しました。small-asmは、そのソースをVMが読めるバイト列のファイルへ変換する道具です。これまではechoだけを入力したあと、Text>という入力待ちの表示で文章を受け取っていました。
今回は、echo helloのように、コマンドと文章を同じ行へ入力できるようにします。入力を保存したメモリの中で、コマンド名と、その後ろの本文を分けます。本文のhelloが表示され、次のコマンドを入力できれば、今回の目的を達成できます。
変更するのはVM上で動くプログラムです。VM本体や変換ツールへ新しい命令を追加せず、文字を読む命令、比較する命令、分岐する命令を組み合わせます。前回のサンプルは残し、今回はprograms/command-arguments.asmという別のソースを使います。開発手順ではDay 41、記事では第21回にあたります。
手元で試すには、連載のプロジェクト一式、Cコンパイラ、makeが必要です。後半の自動テストにはPython 3も使います。プロジェクトのMakefileがあるディレクトリを端末で開き、次を実行してください。
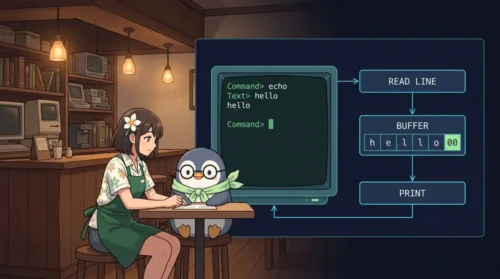
make run-command-argumentsこのコマンドはVMとsmall-asmを用意し、ソースをprograms/command-arguments.binへ変換して起動します。Command>と表示されたら、echo helloと入力してEnterを押します。続いてechoだけを入力し、Text>へhelloを入力してください。最後にCommand>へquitを入力します。
Command> echo hello
hello
Command> echo
Text> hello
hello
Command> quit
Goodbye from Handmade VM
CPU halted.この画面例には、端末が表示する入力文字も含めています。Command>やText>自体は入力しません。最初のecho helloでは次の行を待たずに本文を表示し、echo単独では従来の入力方法を使えることが分かります。
今回はバイナリを直接起動しています。引数なしの./handmade-vmから起動する場合は、host側monitorの>へprograms/command-arguments.binを入力します。Command> quitはVM上のプログラムを終了する操作です。monitor自体を終了するには、戻った>で改めてquitと入力します。
今回の練習ノートとコードは、GitHubの handmade-vm-os に置いています。
コマンドの後ろへ渡す情報を「引数」と呼びます。今回は複数の引数へ細かく分けず、残りを1つの本文として扱います。例えばecho hello worldでは、hello world全体が表示する文章です。
先頭の半角空白          読み飛ばす
コマンド直後の半角空白  連続していても区切りとして読み飛ばす
本文中・末尾の空白      そのまま保持
echo単独                Text>で次の行を読む
echoの後に空白だけ      空本文としてLFだけ表示
help / quitの非空引数   Unknown command
タブ・引用符 区切りや特別な構文として解釈しない半角空白は文字コード0x20、10進数では32です。区切りをこの1種類に限定すると、「今読んだ1 byteが32か」を比較するだけで分割を追えます。タブも区切りにする設計は可能ですが、まずは1つの境界を見つける処理に絞ります。
特に区別したいのは、echo単独と、末尾に半角空白があるecho です。どちらも表示する文字はありませんが、今回は前者で次の行を読み、後者で空本文を表示します。本文の長さだけではこの違いが消えるので、「区切りがあったか」も覚えておきます。
例えば、echo のあとにhelpを入力すると、helpは次のコマンドになります。空白なしのechoのあとに入力したhelpは本文として表示します。入力方法の違いが次の行の扱いを変えるため、ここは仕様とテストの両方に残します。
help やquit のように、後ろが半角空白だけの場合は受け付けます。help xやquit xはUnknown commandとして再入力へ戻ります。空行や半角空白だけの行も、コマンド名がないため同じ扱いです。
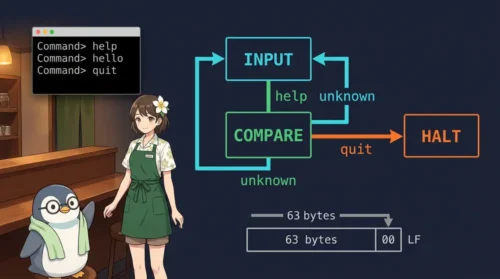
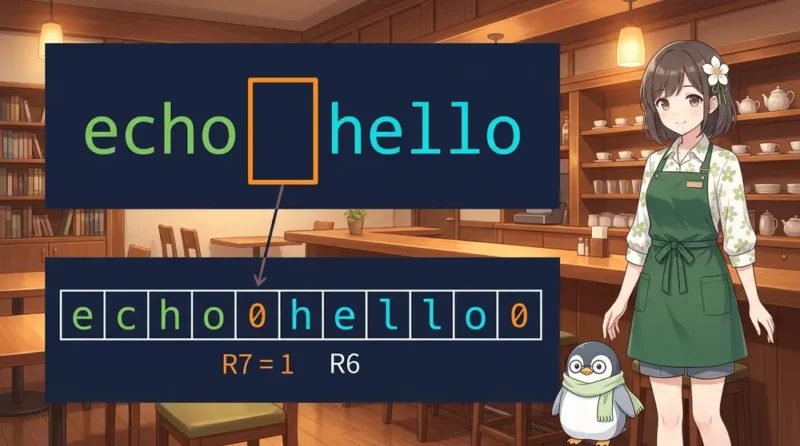
入力を保存する場所を入力バッファと呼びます。今回は、前回と同じ0x500から0x53Fまでの64 byteを使います。最大63 byteの入力と、文字列の終わりを示す0を保存する領域です。まずecho helloが入ったメモリを見てみます。
アドレス  500 501 502 503 504 505 506 507 508 509 50A
入力直後   e   c   h   o  空白  h   e   l   l   o   0
分割後     e   c   h   o   0    h   e   l   l   o   0
                         ↑    ↑
                      名前の終端  本文の先頭(0x505)

R6 = 0x505  本文を読む位置
R7 = 1 区切りがあった表のアドレスは16進数で、省略して記載しています。例えば500は0x500です。0は文字の「0」ではなく、値が0のbyteを表します。文字列を比較・表示する処理は、この値を見つけると終わりだと判断します。
最初の区切りを0に変えるだけで、echoを独立した文字列として比較できます。helloを別の場所へコピーする必要はありません。本文が始まるアドレスをレジスタR6へ保存しておけば、そこから読み進められます。レジスタは、VMが処理中の値を置く小さな保存場所です。
連続する空白があれば、R6をさらに進めます。例えばecho hi なら、コマンドの直後の空白3個を越えたhを本文の先頭にします。本文の読み取りを始めたあとは空白を飛ばさないので、最後の空白2個は残ります。
分割を担当するsplit_lineは、先頭の空白を読み飛ばし、コマンド名の末尾を探し、区切りがあれば本文の先頭へ進む、という順番です。名前の末尾を探す途中で0に出会った場合は、区切りなしとして終わります。次は実際のソースから取り出した処理です。
split_line:
    MOVI R6, 0x500
    MOVI R7, 0
    MOVI R2, 32
    MOVI R3, 0
skip_leading:
    LDB R0, [R6]
    CMP R0, R2
    JNZ scan_command
    INC R6
    JUMP skip_leading
scan_command:
    CMP R0, R3
    JZ split_done
    CMP R0, R2
    JZ split_separator
    INC R6
    LDB R0, [R6]
    JUMP scan_command
split_separator:
    MOVI R0, 0
    STB [R6], R0
    MOVI R7, 1
skip_separator:
    INC R6
    LDB R0, [R6]
    CMP R0, R2
    JZ skip_separator
split_done:
RETMOVIは数値をレジスタへ置く命令、LDBはメモリから1 byteを読む命令です。CMPは2つのレジスタを比較し、等しければzero_flagという状態を真にします。JZは等しかったとき、JNZは等しくなかったときに、指定した名前の位置へ分岐します。INCはレジスタの値を1増やします。
ここでR6を1増やすのは、次の文字のアドレスへ進むためです。scan_commandでは、0なら終わり、32なら区切り、それ以外なら次の文字、という3つの道を選びます。区切りを見つけたsplit_separatorでは、STBで0を書き込み、R7を1にします。
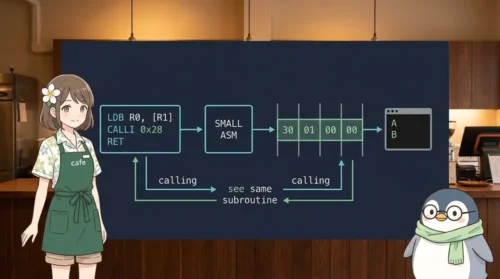
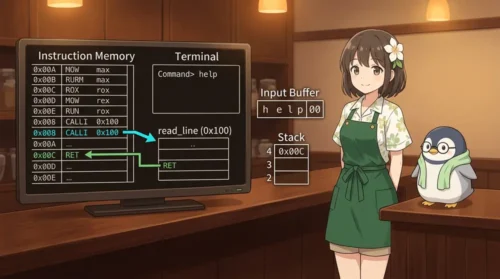
CALLIでこの処理を呼ぶと、戻る位置をスタックという一時保存領域へ積みます。最後のRETはその位置へ戻る命令です。今回の分割処理から別の処理を呼ぶことはなく、呼び出しと戻りは1組です。
分割の中心は、アドレスが示す場所の1 byteを読むことです。LDB R0, [R6]を、VMが命令の部品へ分解するdecodeを挟んで見てみます。rdは読み取った値の保存先レジスタ番号、rsはアドレスを入れたレジスタ番号です。
Assembly: LDB R0, [R6]
命令値:   0x30060000
decode:   type=3, op=0, rd=0, rs=6
Cの対応:  vm->regs[inst.rd] = vm->memory[vm->regs[inst.rs]];

R6が0x504で、その場所に半角空白がある場合:
  rs = 6                      レジスタの番号
  vm->regs[6] = 0x504          そのレジスタ内のアドレス
  vm->memory[0x504] = 32       そのアドレスにあるデータ
vm->regs[0] = 32 読み取った結果命令を読むfetchでは、PCという次の命令位置を示す値から4 byteを読み、PCを4進めます。decodeで上の番号を取り出し、実行するexecuteで実際のメモリを読みます。rsの6をそのままメモリアドレスにすると、0x504とは別の場所を読んでしまいます。番号、アドレス、その場所の中身を順に分けると追いやすくなります。
区切りを書き換えるSTB [R6], R0では、R0に入れた0を、R6が示す場所へ保存します。これも入力全体を動かす処理ではなく、メモリの1 byteだけを変更する処理です。
分割ができても、コマンド名の比較で本文の位置を壊してしまうと表示できません。比較にはR0からR4を使い、本文の位置はR6、区切りの有無はR7に残します。どのレジスタを変更するかを決めておくことも、処理を組み合わせるための仕様です。
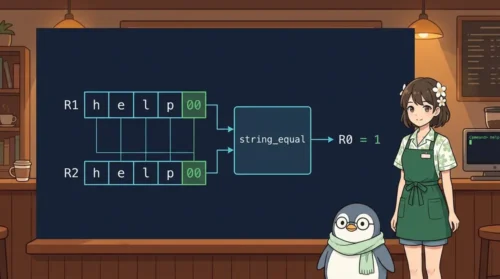
compare_commandは、比較のたびにR1を0x500へ戻して先頭空白を読み飛ばします。その後は前回の文字列比較と同じです。比較するたびに読み取り位置が進むため、次のコマンド名を試す前に先頭へ戻す必要があります。
compare_command:
    MOVI R1, 0x500
    MOVI R3, 32
find_command:
    LDB R0, [R1]
    CMP R0, R3
    JNZ string_equal
    INC R1
    JUMP find_command
string_equal:
    MOVI R4, 0
compare_loop:
    LDB R0, [R1]
    LDB R3, [R2]
    CMP R0, R3
    JNZ not_equal
    CMP R0, R4
    JZ equal
    INC R1
    INC R2
    JUMP compare_loop
equal:
    MOVI R0, 1
    RET
not_equal:
    MOVI R0, 0
RET一致ならR0に1、不一致なら0が入ります。コマンドループでは、まずechoを調べます。一致したらR7を見て、本文の表示か、次の行の読み取りかを選びます。echoでなければ、本文が空であることを確認してからhelpとquitを比較します。
同じ行の本文はLDB R0, [R6]で1 byteずつ読み、SYSCALL 3で表示します。SYSCALLはVMからhost側の入出力処理を利用する命令です。番号3は改行を付けずに1文字を表示するので、終端0まで進んだあと、値10のLFを1回表示します。
do_echo:
    MOVI R3, 0
    CMP R7, R3
    JZ read_echo_text
print_argument:
    LDB R0, [R6]
    CMP R0, R3
    JZ print_newline
    SYSCALL 3
    INC R6
    JUMP print_argument
read_echo_text:
    MOVI R0, text_prompt
    SYSCALL 1
    CALLI read_line
    MOVI R0, 0x500
    SYSCALL 1
print_newline:
    MOVI R0, 10
    SYSCALL 3
JUMP command_loop既存のsmall-asmにはレジスタ間で値をコピーするMOV構文がありません。本文の位置をR0へコピーするために変換ツールを広げるより、今回はR6を使って順番に読む形にします。echo単独の経路では、従来どおりread_lineで入力し、SYSCALL 1で0終端文字列を表示します。
行入力の処理は前回と共通です。LFで行を確定し、CRは無視します。保存上限を超えてもLFまでは読み続けるので、長い行の残りが次のコマンドへ混ざりません。行の途中で入力が終わるEOFでは、未完成の行を実行せずVMが停止します。
今回の上限も63 byteですが、同じ行にコマンド名を置く分、表示できる本文は短くなります。echo で5 byte使うため、この入力形なら本文は最大58 byteです。先頭空白や余分な区切りが増えれば、その分だけ本文を保存できる長さも減ります。
保存後の内容を分割する点にも注意します。先頭に59個の空白があると、残り4 byteへechoが入り、その後の区切りは保存されません。この場合はecho単独として次の行を読みます。58個の空白なら最後の1 byteへ区切りが入り、空本文として扱えます。境界の違いは部品テストと入出力テストで確かめます。
入力中のNUL、つまり値0のbyteは保存しますが、文字列として扱う範囲は最初のNULまでです。入力自体はその後もLFまで消費します。また、上限は文字数ではなくbyte数なので、日本語などのUTF-8は文字の途中で切れることがあります。これは今回の分割で新しく変えた規則ではなく、既存の行入力を引き継いだ結果です。
手で動かして目的の表示を確認したら、自動テストで境界を確かめます。まず分割処理だけを検査します。
make test-command-splitcommand-split: 14 cases passedこのテストは、実ソースのsplit_lineを一時的なVMプログラムに組み込みます。分割後のバッファ、本文のアドレス、区切りの有無を、あらかじめ用意した14組の期待値と比較します。テスト側が同じ分割方法で期待値を計算すると同じ間違いを見落とすため、期待するbyteやアドレスを直接記述しています。
次に、生成したバイナリ全体をVMで動かします。
make test-command-argumentscommand-arguments: 74 cases passed; 600 bytes <= 0x50073ケースはバイナリの直接実行、1ケースはmonitorからの実行です。終了コード、標準エラー、表示全体を照合します。空白、空本文、echo単独に加え、CRLF、EOF、NUL、UTF-8、上限の前後、1000回の反復を確認します。helpやquitに本文が付いたときに、誤って終了しないことも対象です。
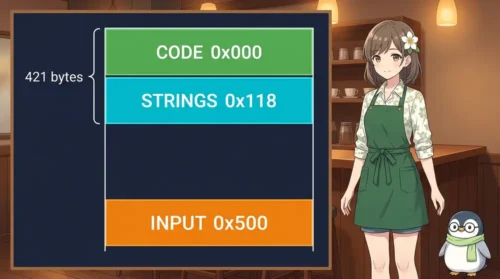
生成物は112命令で448 byte、表示用などの8文字列が152 byte、合わせて600 byteでした。ファイル末尾の次の位置は0x258で、入力バッファの0x500より手前です。今回もバイナリの中へ入力用の空き領域を含める必要はなく、VMが用意したメモリを使います。
前回のasm版とwriter版はそれぞれ54ケースのまま維持しています。今回は動作を増やしたため、新旧のファイル全体が同じになることは求めません。前回の約束は前回のテストで、新しい入力規則は今回のテストで確かめます。
同じ行でコマンドと文章を受け取るには、文字を読むだけでなく、どこまでが名前で、どこからが本文かを決める必要がありました。区切りを0へ置き換え、本文のアドレスと区切りの有無を残すことで、既存の比較処理と表示処理につなげられます。
仕様カードはmanual/specs/041-command-arguments.md、実装全体はprograms/command-arguments.asm、テストの説明はmanual/test-code-explanations/041-command-arguments.mdにあります。ここで掲載したコードは、全体から分割・比較・表示の部分を取り出したものです。実行するときはプロジェクト内の完全なソースを使ってください。
次の候補は、メモリ上で1行を保持し、表示・置換する小さな編集機能です。コマンドを入力する場所と、編集する文章を残す場所を分ける仕様から考えます。ファイルへの保存や画面全体の制御は、その後の段階として扱います。