System Note
$ cat /proc/ai-disclosure
本記事の構成および論理分析にはAI(人工知能)を使用しています。情報の正確性は、システム管理者(UNIXユーザー)による手動検証済みです。
前回は、echoと入力した後に次の1行を読み、その内容を表示してコマンド入力へ戻る処理を作りました。入力と文字列比較の部品を再利用し、同じ入力バッファを本文にも使いました。コマンドを増やすために、新しいVM命令を追加する必要はありませんでした。
ここまでのプログラムは、Cで書いた専用の生成プログラムでファイルにしていました。これを記事ではwriterと呼んでいます。writerが作るのは、VMが実行できる数値の並びを入れた .bin ファイルです。
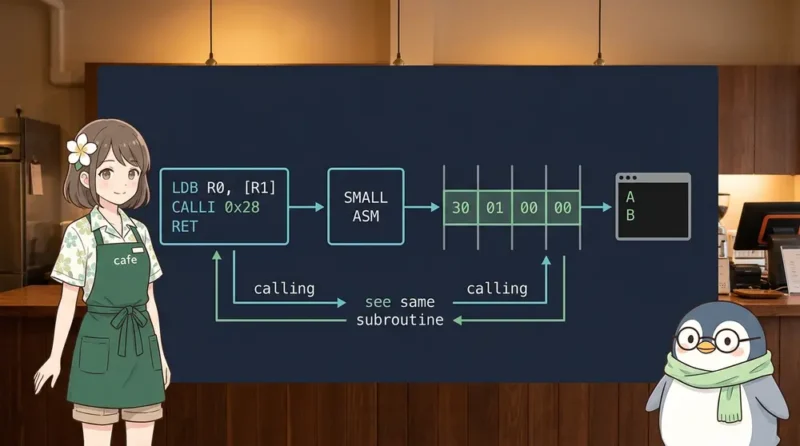
一方、MOVI R0, 65 のように命令名を使って書く方法もあります。この書き方がアセンブリで、それをVM用の数値に変換する道具が、自作アセンブラのsmall-asmです。今回はsmall-asmが読める命令を増やし、メモリへの保存や、同じ処理の呼び出しを .asm ファイルに書けるようにします。
流れは「.asm に命令を書く → small-asmで .bin に変換する → VMで実行する」です。small-asmは変換を担当し、VMは実行を担当します。この役割を押さえてから、小さなプログラムを動かしてみましょう。
Day 37: tools/small-asm.c
        programs/asm-memory-call.asm
        tools/test-small-asm.py
今回の練習ノートとコードは、GitHubの handmade-vm-os に置いています。
small-asmに追加するのは、LDB、STB、INC、CALLI、RETの5つです。どれもVM本体ではすでに実行できます。今回作るのは、命令名やレジスタ名を読み、VMが読める数値へ変換する処理です。このVMでは1命令を32bit、つまり4バイトの数値で表します。
LDB R0, [R1]   ; R1が指す場所から1 byte読む
STB [R1], R0   ; R1が指す場所へ1 byte書く
INC R1         ; R1を1増やす
CALLI 0x28     ; 戻り先を保存し、0x28へ移る
RET            ; 保存した戻り先へ戻る
レジスタは、VMが数値を一時的に置く場所で、R0〜R7の8個があります。メモリには、アドレスという番号を指定して値を保存します。今回はメモリへAとBを書き、同じ「1文字を表示する処理」を2回呼ぶサンプルを用意します。このように、呼び出して使い、終わったら元の場所へ戻る処理をサブルーチンと呼びます。入力処理や文字列比較を丸ごと移す前に、書く、読む、位置を進める、呼ぶ、戻るという5つの変換を確かめます。
呼び出し先は、今回も数値のアドレスで書きます。CALLI print_byte のように名前を使うラベルや、文字列をソースに置く機能は後の段階です。echo全体のバイナリをsmall-asmだけで作るところまでは進めません。
取得したコードのうち、Makefileがあるディレクトリで、次のコマンドを実行します。Cコンパイラとmakeを使い、必要なVMとsmall-asm、サンプルのバイナリを作って実行します。
make run-asm-memory-callビルド中の表示を除くと、実行結果は次の3行です。今回はキーボードからの入力を待ちません。
A
B
CPU halted.
画面だけを見ると短い表示ですが、AとBは、それぞれメモリから読み出しています。「メモリから1文字読んで表示する処理」を1つ用意し、読む位置を変えて2回使っています。
手順を分けて試す場合は、次のように実行できます。最初のmakeで道具を作り、次の行でアセンブリを一時ファイルへ変換し、最後にVMへ渡します。
make tools/small-asm handmade-vm
./tools/small-asm programs/asm-memory-call.asm /tmp/asm-memory-call.bin
./handmade-vm /tmp/asm-memory-call.bin
変換時には assembled 14 instructions to /tmp/asm-memory-call.bin と表示されます。1命令は4 byteなので、出力ファイルは14 × 4で56 byteです。あとで登場する0x500は、VMのメモリ内でAを保存する場所です。AとBは実行中に命令で書き込むので、ファイルに入れておくのは14個の命令だけで済みます。なお、0x で始まる数は16進数です。10進数の10〜15をA〜Fで表すので、0x0Cは12、0x10は16になります。
まずは、変換の仕組みへ入る前に、サンプルが何をするかを見ておきます。流れは「AとBを保存する → 読む位置をAへ戻す → 表示処理を2回呼ぶ」です。今回のソース全体は次の通りです。右側のコメントは各命令の配置先です。コメントや空行は出力されないため、命令を1つ書くごとにアドレスが4ずつ進みます。ここで [R1] は「R1に入っているアドレスのメモリ」を表します。R1が0x500なら、STBはメモリの0x500番地へ書き込み、LDBはそこから読みます。
; Day 37: store A/B, then call the same byte-printing routine twice.
MOVI R1, 0x500       ; 0x00
MOVI R0, 65          ; 0x04
STB [R1], R0        ; 0x08
INC R1              ; 0x0C
MOVI R0, 66          ; 0x10
STB [R1], R0        ; 0x14
MOVI R1, 0x500       ; 0x18
CALLI 0x28          ; 0x1C
CALLI 0x28          ; 0x20
HALT                ; 0x24
LDB R0, [R1]        ; 0x28
SYSCALL 0           ; 0x2C
INC R1              ; 0x30
RET                 ; 0x34
MOVI は、レジスタに数値を入れる命令です。最初にR1へ保存先の0x500、R0へ文字Aを表す65を入れ、STBでメモリへ書きます。文字もメモリには数値として保存します。ASCIIという文字コードではAが65(16進数で0x41)、Bが66(0x42)です。INCでR1を0x501へ進め、今度は66、つまりBを書きます。ここまでで、メモリには次の2 byteが並びます。
memory[0x500] = 0x41  A
memory[0x501] = 0x42  B
その後、R1を0x500へ戻します。書き込みを終えた直後は0x501を指しているので、そのまま読むとBから始まってしまいます。保存するときに進めた位置と、表示を始めたい位置を分けて考えます。
サブルーチンの前には10命令あるので、その先頭は10 × 4 = 40、16進数で0x28です。2つの CALLI 0x28 は、どちらもこの場所を呼びます。0x28からのサブルーチンは、R1が指す1 byteをR0へ読み、SYSCALL 0で1文字と改行を表示し、R1を1増やして戻ります。1回目でAを表示した後はR1=0x501になり、2回目は同じ命令列でBを表示できます。
このサブルーチンへ渡す値はR1のアドレスです。戻った後のR1は次のbyteを指し、R0には読んだ文字が残ります。今回は、位置を進めることもサブルーチンの仕事として決めています。呼び出し元が毎回R1を設定し直す必要はありません。
文字列の終端0は置いていません。この例では「2回呼ぶ」という命令列で表示回数を決め、SYSCALL 0で1文字ずつ表示するからです。前回のSYSCALL 1による0終端文字列の表示とは、止め方が違います。
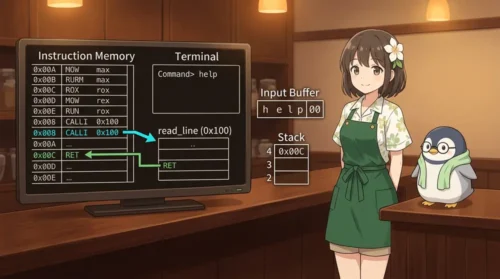
PC(プログラムカウンタ)は、VMが次に読む命令のアドレスを持つ場所です。普段は1命令を読むたびに4ずつ進みますが、CALLIとRETでは別のアドレスへ移ります。
2つのCALLIは、どちらも0x28へ向かいます。それでも、戻り先は同じではありません。CALLIを読み取った時点でPCは4進んでおり、その次の命令のアドレスを保存するためです。
1回目: 0x1CのCALLI
  保存する戻り先 = 0x20
  PC = 0x28へ
  Aを表示し、R1 = 0x501
  RETでPC = 0x20へ

2回目: 0x20のCALLI
  保存する戻り先 = 0x24
  PC = 0x28へ
  Bを表示し、R1 = 0x502
  RETでPC = 0x24へ

0x24のHALTで終了
戻り先を覚えておく場所が、メモリ内のスタックです。スタックは、最後に保存したものから取り出す仕組みで、その位置をSP(スタックポインタ)が管理します。今回は、CALLIで戻り先を1つ保存し、RETで取り出す、という使い方です。
戻り先のアドレスは4バイトなので、CALLIはSPを4減らして保存場所を確保します。SPは初期値の0x100000から0x0FFFFCになり、RETで戻り先を読み出すと元に戻ります。1回目が終わってから2回目を呼ぶため、2回目にも同じ場所を使えます。
メイン処理の末尾にHALTがあることも確認します。サブルーチンはファイル内では、そのすぐ後ろにあります。HALTがなければ、通常の順次実行でサブルーチンへ入ってしまう可能性があります。呼び出して入る場所と、メイン処理を終える場所を命令で区切っています。
追加する命令を決めるため、前回の tools/write-echo-command-bin.c と、small-asmの対応命令を比べます。VMが持つ全命令を一度に対象にするのではなく、すでに動いているechoが使うものを基準にします。
これまでのsmall-asm:
  MOVI / SYSCALL / HALT / CMP / JUMP / JZ / JNZ

echoのwriterで使い、small-asmに足りなかった命令:
  LDB / STB / INC / CALLI / RET
前回の入力ルーチンはSTBで1 byteを保存し、INCで保存位置を進めます。比較ルーチンはLDBで文字を読みます。それらをCALLIで呼び、RETで戻ります。この5つが加わると、echoの命令部分で使う12種類がそろいます。
命令がそろうことと、プログラム全体を生成できることは分けて考えます。echoにはCommand>などの文字列や比較語、命令と文字列の間の空き領域も必要です。今回のsmall-asmは、読んだ命令を先頭から4 byteずつ並べるところまでです。
命令名に続けて書く値をオペランドと呼びます。たとえば INC R1 ではR1、CALLI 0x28 では0x28がオペランドです。名前を認識するだけでなく、個数と書き方も決めておきます。
分類: 手元のPCで動かす、VM用プログラムの変換ツール
追加命令: LDB / STB / INC / CALLI / RET
レジスタ: R0〜R7
メモリ参照: [R0]〜[R7]。角括弧の内部に空白を入れない
CALLI: 0〜0xFFFFFの数値アドレスを1つ指定
RET: オペランドなし
出力: 1命令4バイト、大きい桁の側から順に書く(big-endian)
未対応: ラベル、文字列、配置指示、数値の式命令名とレジスタ名の大文字・小文字は区別しません。ldb r0, [r1] も使えます。空行を飛ばし、セミコロンまたは#以降をコメントとして読み飛ばす規則も、これまでと同じです。
既存のsmall-asmは、カンマを空白に置き換えてから単語を分けます。そのため、カンマを省いた LDB R0 [R1] も受け付けます。今回はこの区切り方を引き継ぎ、サンプルでは読みやすいようにカンマを付けます。一方、角括弧はメモリ側を示すものとして必須にします。
CALLIには、呼び出したい命令のアドレスをそのまま書きます。今回は CALLI 0x28 のように、0x付きの16進数にそろえます。10進数も使えますが、先頭に0を付けると8進数になるので、桁をそろえるための0は付けないようにします。
呼び出し先の数値を入れる場所は20bit分なので、0〜0xFFFFFに収まるかを調べます。ただし、その場所に命令があるかまでは調べません。たとえば3も数値としては変換できます。今回のサンプルでは、実在する命令の先頭0x28を指定します。数値が書けたことと、正しい呼び出し先を選べたことは別の確認です。
ここからは、small-asmのCコードが命令をどう読み取るかを見ていきます。LDBの2つ目の指定と、STBの1つ目の指定には角括弧が付きます。[R1] は「R1というレジスタ」ではなく、「R1に入った値をアドレスとして使ったメモリ」を表します。
LDB R0, [R1]
  R0へ memory[R1] の1 byteを読む

STB [R1], R0
memory[R1] へ R0の下位8bitを書くたとえばR1に0x500が入っていれば、[R1] はメモリの0x500番地を指します。R1の中身は「場所」、その場所に保存されているAなどの値は「データ」です。この2つを分けて読むと、LDBとSTBの動きを追いやすくなります。
この角括弧付きの指定を読む関数として、parse_memory_register を追加します。まず文字列が4文字で、最初と最後が角括弧か確認します。中のRと数字を取り出した後は、すでにあるレジスタ解析関数を使います。
static int parse_memory_register(const char *text, uint8_t *reg) {
    if (strlen(text) != 4 || text[0] != '[' || text[3] != ']') {
        return 0;
    }

    char name[] = {text[1], text[2], '\0'};
    return parse_register(name, reg);
}
[R1] は、先頭から [、R、1、] の4文字です。Cの配列は0から数えるので、text[1] と text[2] を取り出すとRと1が残ります。末尾の '\0' は、Cの文字列がここで終わることを示す印です。こうして作った R1 を既存の parse_register へ渡し、使えるレジスタか確認します。この関数は、成功なら1、失敗なら0を返します。
この形なら、[R8] はレジスタ番号の検査で拒否され、[[R1]] や括弧の欠落は外側の検査で拒否されます。[ R1 ] のような書き方も、今回の構文では扱いません。空白で分割した後の1つのオペランドとして、[R1] を受け取る設計です。
LDBでは第1オペランドを通常のレジスタ、第2オペランドをメモリ参照として調べます。STBではその順序を逆にします。両方を通常のレジスタとして読んでしまうと、書いた人がメモリを指定したつもりかどうかを確認できません。
オペランドを読み取ったら、命令値を組み立てます。LDBは0x30000000、STBは0x31000000が土台です。命令の中には、1つ目のレジスタ番号を入れる欄rdと、2つ目を入れる欄rsがあります。番号をそれぞれ20bit、16bit左へずらすと、その欄に収まります。Cでは << が左へずらす演算、| が各部分のビットを合わせる演算です。
*inst = (is_load ? 0x30000000 : 0x31000000) |
        ((uint32_t)rd << 20) | ((uint32_t)rs << 16);
この式の is_load ? ... : ... は、LDBなら0x30000000、STBなら0x31000000を選ぶ部分です。*inst には、組み立てた命令値を書き込みます。
具体例として、番号が異なるレジスタを使ってみます。同じ番号同士だけで確認すると、rdとrsを逆に入れた間違いを見落とすためです。
LDB R2, [R7]
  0x30000000 | 0x00200000 | 0x00070000
  = 0x30270000
  出力するbyte列: 30 27 00 00

STB [R7], R2
  0x31000000 | 0x00700000 | 0x00020000
  = 0x31720000
  出力するbyte列: 31 72 00 00
STBのrdは、書き込み先のアドレスを持つレジスタです。R7そのものへR2をコピーする命令ではありません。ここでのrdは「命令の中にある番号の欄の名前」です。STBが書き換えるのは、その番号のレジスタが指しているメモリです。
角括弧という文字は、出力するバイナリには入りません。読み取りか書き込みかは命令の種類で決まり、アドレスに使うレジスタ番号が命令の決まった位置へ入ります。VMはこの4バイトから命令の種類とレジスタ番号を取り出して実行します。この取り出す処理をdecodeと呼びます。
INCはレジスタを1つだけ受け取る命令です。R0〜R7か確認し、0x20000000へ番号を入れます。INC R7 なら0x20700000です。余分なオペランドがあればエラーにします。
CALLIはJUMP、JZ、JNZと同じく、下位20bitに数値を入れます。命令の大きな分類を示すtypeは6で、その分類の中からCALLIを選ぶ番号opは9です。ソースに直接書く数値を「即値」と呼び、コードではimmと表しています。数値を読む処理は既存のJUMPなどと共通にできます。
CALLI 0x28
  type = 6
  op   = 9
  imm  = 0x28
  命令値 = 0x69000028
byte列 = 69 00 00 28RETにはオペランドがなく、命令全体が0x02000000です。HALTと同じく、後ろに余分な単語がないことを確認して、固定値を返します。RET R0 のように、使わない値を黙って読み捨てる形にはしません。
small-asmがCALLIを変換している時点では、サブルーチンは呼ばれません。手元のパソコン上で、ファイルへ命令値を書いている段階だからです。戻り先をスタックへ保存するのは、そのバイナリをVMが読み込み、CALLIを実行したときです。
画面にAとBが出ただけでは、すべての構文や境界値が正しく変換されたとは限りません。たとえば、R1では正しく動いてもR7では変換を間違える可能性があります。そこで「できあがった数値が正しいか」と「VMで動かした結果が正しいか」の両方を、自動テストで確かめます。Python 3を使い、次のコマンドで実行します。
make test-small-asm成功すると、最後に次の行が出ます。
small-asm: 59 cases passed固定の期待値では、たとえば LDB R2, [R7] が30 27 00 00になることを調べます。使えるレジスタの最初と最後であるR0とR7、直接書ける数値の最小と最大である0と0xFFFFFも試します。こうした範囲の端にある値を、境界値と呼びます。大小文字やコメントを含むソースも変換します。
不正入力では、R8、即値の範囲超過、角括弧の欠落、余分なオペランド、未対応のラベルなどを渡します。終了コードが1になり、入力ファイル名と行番号を含む診断が標準エラーへ出ることを確認します。長すぎる行も対象です。
既存のhelloや1文字コマンドループなど5つのソースも、一時ファイルへ変換し、保存済みのバイナリと比較します。新しい命令を足した後でも、従来のソースが同じbyte列になることを調べるためです。
さらに、Day 36のread_lineとstring_equalを数値アドレスで書いた31命令を変換し、writerが作ったバイナリの0x09Cから0x117までと照合します。CALLIも別に照合します。今回の追加が、すでに動いているwriterと同じ命令値を作ることを確認できます。
この31命令は、元のプログラム内の絶対アドレスを使った照合用の断片です。切り出して先頭0へ置き、そのまま実行するものではありません。実行の確認には、先頭から完結する14命令のサンプルを使い、標準出力全体、標準エラー、終了コードを期待値と比べます。
既存のsmall-asmと同じく、変換に失敗した場合には、途中まで書かれた出力ファイルが残ることがあります。ファイルの存在だけで成功と判断せず、エラーが出た出力は実行しません。今回のテストでも、成功を確認してから出力内容を比較しています。
今回は、メモリ操作とサブルーチンに使う5命令をsmall-asmへ追加しました。オペランドの形を確認し、レジスタ番号や即値を所定のbit位置へ入れることで、writerと同じ命令値を生成できました。
VM側が実行できる命令と、アセンブラ側が読める表記は別々に増やせます。今回はVM本体を変更せず、プログラムを書く入口を広げました。AとBの短い表示でも、メモリ、レジスタ、PC、SPの動きを順に追えます。
残っている不便さは数値アドレスです。たとえばサブルーチンより前に1命令を挿入すると、先頭は0x28から0x2Cへ動きます。その場合は、2つのCALLIの数値も直さなければなりません。命令の変換が正しくても、古い数値は自動では更新されません。
次は、固定長の命令列にラベルを付け、呼び出し先や分岐先を名前で書けるようにする仕様を決めます。後ろに定義する名前をどう解決するかを確認し、文字列データの配置はさらに次の段階へ分けます。